쿠버네티스는 이제 클라우드 인프라의 표준 운영 기반으로 자리 잡았습니다. CNCF가 2026년 1월 발표한 클라우드 네이티브 설문¹에 따르면 컨테이너 사용자의 82%가 쿠버네티스를 프로덕션에서 운영하고 있습니다. 2023년 66%에서 2년 만에 16%p 증가한 수치입니다.
1. CNCF, Kubernetes Established as the De Facto ‘Operating System’ for AI as Production Use Hits 82% in 2025 CNCF Annual Cloud Native Survey, 2026
쿠버네티스의 역할은 AI 워크로드로도 확장되고 있습니다. 같은 조사에서 생성형 AI 모델을 호스팅하는 조직의 66%가 추론 워크로드의 일부 또는 전체를 쿠버네티스로 관리한다고 답했습니다.
반면 쿠버네티스 도입 과제로 교육 부족을 꼽은 응답은 여전히 36%에 달합니다. 기술 표준은 자리 잡았지만 이를 실제 환경에서 다뤄본 인력은 여전히 부족하다는 의미입니다. 이 간극을 직접 실습으로 메우고 있는 커뮤니티가 Cloud Club입니다.
Cloud Club은 클라우드에 관심 있는 사람들이 모여 특정 벤더에 종속되지 않는(vendor-neutral) 폭넓은 클라우드 인프라 경험을 추구하는 IT 연합 동아리입니다. CNCF 기술을 포함해 클라우드 네이티브 관련 오픈소스를 직접 다뤄보는 것을 목표로 DevOps·데이터 엔지니어링·MLOps 등 다양한 주제의 스터디와 프로젝트를 운영하고 있습니다.
이번 9기 스터디원분들은 커널 레벨 네트워킹(eBPF), 장애 대응과 관측성, AI 기반 운영 자동화(AIOps) 등 앞서 살펴본 시장 흐름과 맞닿은 주제를 다뤘습니다. 가비아 클라우드는 이 여정에 클라우드 크레딧을 후원하며 스터디에 필요한 실습 인프라를 지원했습니다.
1. 쿠버네티스 네트워크 플러그인 ‘Cilium’ 스터디
Cilium이란 리눅스 커널의 eBPF(extended Berkeley Packet Filter)를 기반으로 쿠버네티스의 네트워킹, 보안 정책, 관측성을 제공하는 오픈소스 CNI(Container Network Interface)입니다. 리눅스 iptables 규칙 대신 커널 내부에서 패킷을 직접 처리해 대규모 클러스터에서도 높은 성능을 낼 수 있다는 장점이 있습니다.
Cilium을 제대로 이해하려면 쿠버네티스 추상화 아래에 있는 리눅스 네트워크 스택과 커널 동작까지 함께 살펴봐야 합니다. 이번 스터디는 쿠버네티스 네트워크가 리눅스 커널에서 실제로 어떻게 동작하는지 확인하기 위해 eBPF 기반 CNI인 Cilium의 데이터패스를 코드 레벨까지 추적했습니다. 학습 난도가 높은 네트워크 영역을 함께 공부하고 논의하는 것을 목표로 진행되었습니다.
주차별 커리큘럼
리눅스 네트워크 기본기에서 출발해 쿠버네티스 네트워킹, Calico, Cilium, Hubble을 거쳐 성능 비교와 커널 트레이싱까지 단계적으로 다뤘습니다.
| 주차 | 주제 | 세부 내용 |
|---|---|---|
| Week 1 | Linux Network 기본기 | TCP/IP stack · netfilter · iptables · conntrack |
| Week 2 | Kubernetes Networking | CNI 구조 · kube-proxy (iptables vs IPVS) · Service → Pod 흐름 추적 |
| Week 3 | Calico 분석 | BGP · overlay vs underlay · policy enforcement |
| Week 4 | Cilium 구조 | eBPF hook 지점 · kube-proxy replacement · datapath 이해 |
| Week 5 | eBPF networking 실습 | tc / XDP · packet drop program 작성 · latency 측정 |
| Week 6 | Hubble 분석 | flow visibility · L3/L4 policy · observability |
| Week 7 | 성능 비교 실험 | iptables vs Cilium latency · throughput · CPU 사용량 비교 |
| Week 8 | 커널 레벨 tracing | tcp_sendmsg trace · BPF trace 패킷 흐름 추적 · flamegraph 생성 |
가비아 클라우드 활용 방식
7~8주차 실습에서는 가비아 클라우드의 쿠버네티스 서비스로 스터디원별 클러스터를 구성했습니다. 네트워크 실습에서 가장 많은 시간이 드는 단계는 환경 구축입니다. 관리형 클러스터를 활용해 이 과정을 단축하고 성능 테스트와 커널 레벨 모니터링에 집중할 수 있었습니다.
스터디원은 클러스터 위에서 iptables 대비 Cilium의 latency·throughput·CPU 사용량을 측정하고 BPF trace로 패킷이 커널에서 처리되는 경로를 직접 확인했습니다.
스터디원 후기
“클러스터를 구성하는 것이 굉장히 힘든 일인데 가비아 클라우드의 쿠버네티스 서비스를 사용해서 개인마다 쉽게 클러스터를 구성해서 사용할 수 있었습니다.”
“쿠버네티스 클러스터를 구축하는 것이 비용도 굉장히 많이 들고 시간도 오래 소요되는데 가비아 클라우드 서비스를 사용해서 비용과 시간을 크게 줄일 수 있었습니다.”
2. 쿠버네티스 모의 장애 실습 ‘장애를 보는 눈’ 스터디
서비스 장애는 언제 어떤 형태로 찾아올지 예측하기 어렵습니다. 같은 지표와 로그를 보더라도 원인을 얼마나 빠르게 좁혀가는지는 경험에 따라 크게 달라지기 때문에 장애 대응은 이론보다 실전 감각이 중요한 영역으로 꼽힙니다.
‘장애를 보는 눈’은 실무에서 마주할 수 있는 여러 장애 상황을 공유하면서 대응 감각과 프로세스를 익히기 위해 진행된 스터디입니다. 모니터링이라는 추상적인 개념을 실제 장애 시나리오 실습으로 구체화했습니다.
주차별 커리큘럼
| 주차 | 주제 | 세부 내용 |
|---|---|---|
| Week 1–2 | 모니터링 개념 학습 | SLI/SLO/SLA · Metric/Log/Trace · 장애 대응 사례 공유 |
| Week 3–4 | 쿠버네티스 장애 대응 프로세스 | 장애 발생 지점 분석 · 원인 분석 방법 · 오픈소스/상용 도구 알람 설정 사례 |
| Week 5–6 | 문제 기반 장애 대응 실습 | 장애 시나리오 기반 환경 구성 및 해결 |
| Week 7–8 | 모의 장애 대응 플랫폼 실습 | 플랫폼 내 다양한 장애 케이스 해결 |
가비아 클라우드 활용 방식
스터디원은 가비아 클라우드의 쿠버네티스 서비스로 클러스터를 만들고 그 위에 모의 장애 대응 플랫폼을 구축했습니다. 이후 클러스터에 장애 문제를 정의하고 해결하는 방식으로 실습을 진행했습니다.
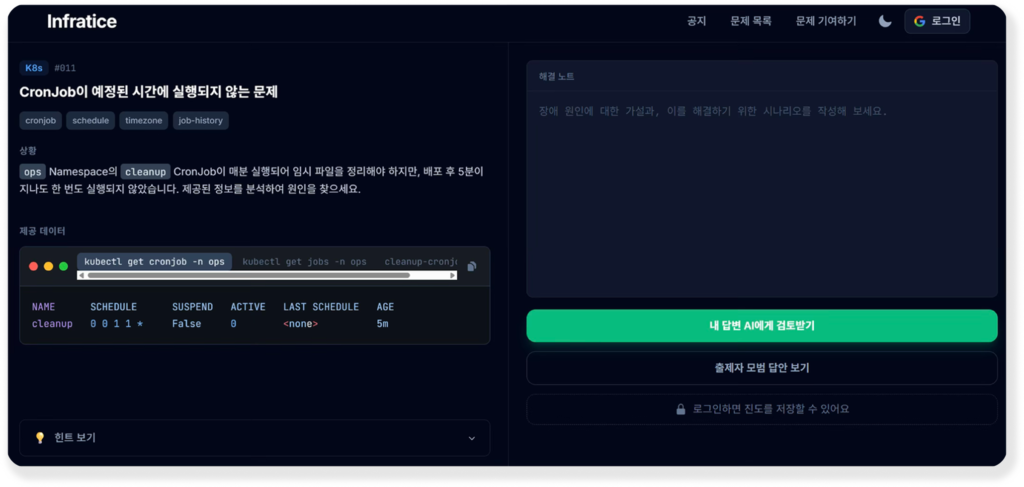
특히 모의 장애 플랫폼 실습은 예상하지 못한 상황을 연속으로 만나는 실제 장애 대응 환경과 유사해 스터디원 사이에서 학습 효과가 높았다는 평가를 받았습니다.
스터디원 후기
“해당 환경을 구성하는 데에 다른 서비스를 사용했다면 큰 비용이 들었을 텐데 가비아 클라우드 서비스 덕분에 비용 걱정 없이 실습이 가능하였습니다.”
3. 배포부터 장애 알림까지 ‘AIOps 배포 고도화’ 스터디
AIOps 배포 고도화 스터디의 목표는 단순히 웹사이트 하나를 배포하는 것이 아니었습니다. 실제 서비스처럼 사용자가 접속하고 기능을 사용할 때 문제가 생기면 AI가 상황을 확인해 알려주는 흐름까지 만들어보는 것이었습니다.
AIOps 배포 고도화 흐름
사용자가 웹사이트에 접속한다
  -> 기능을 사용한다
  -> 서버가 요청을 처리한다
  -> 문제가 생기면 모니터링 시스템이 감지한다
  -> AI가 문제 상황을 요약해 Discord로 알려준다
  -> 필요한 경우 정해진 안전한 범위 안에서 간단한 조치를 실행한다
주차별 커리큘럼
| 주차 | 무엇을 했는지 | 쉽게 말하면 |
|---|---|---|
| Week 1~2 | 전체 아키텍처와 일정 계획 수립 | 어떤 서비스를 만들지, 어떤 서버가 필요한지, 매주 어디까지 만들지 정했습니다. |
| Week 3 | 코드 저장소와 가비아 클라우드 서버 구성 | 개발한 코드를 올릴 공간을 만들고 가비아 클라우드에 실제 서버들을 만들었습니다. |
| Week 4 | 웹사이트, 백엔드, 도메인 연결 | 사용자가 dogsub.cloud로 접속하면 화면이 보이고 버튼을 누르면 서버 기능이 동작하도록 연결했습니다. |
| Week 5 | 코드 리뷰 AI와 모니터링 알림 추가 | 코드에 문제가 없는지 AI가 도와주고 서비스에 문제가 생기면 알림을 받을 수 있게 했습니다. |
| Week 6 | 장애 대응 AI 설계 | 문제가 생기면 AI가 상황을 분석하고 정해진 범위 안에서 간단한 조치를 실행할 수 있도록 구성했습니다. |
| Week 7 | 전체 QA와 최종 점검 | 처음부터 끝까지 서비스가 잘 연결되는지 확인하고 개선할 부분을 정리했습니다. |
처음에는 전체 그림을 그리는 것부터 시작했습니다. 사용자가 접속하는 화면, 요청을 처리하는 서버, 데이터를 저장하는 공간, 문제가 생겼을 때 알려주는 시스템까지 어떤 구성으로 만들지 정했습니다.
이후 가비아 클라우드에 실제 서버를 만들고 코드 저장소와 연결해 배포 기반을 준비했습니다. 가비아에서 구매한 dogsub.cloud 도메인도 연결해 사용자가 웹사이트에 접속하면 화면이 보이고 게시글 작성 기능이 실제로 동작하도록 만들었습니다.
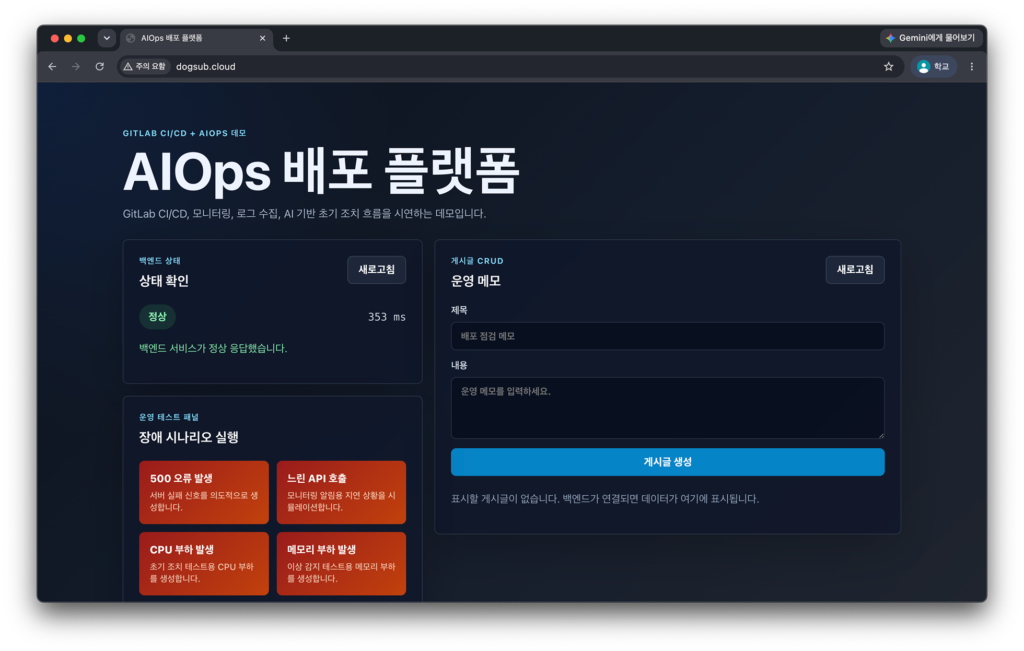
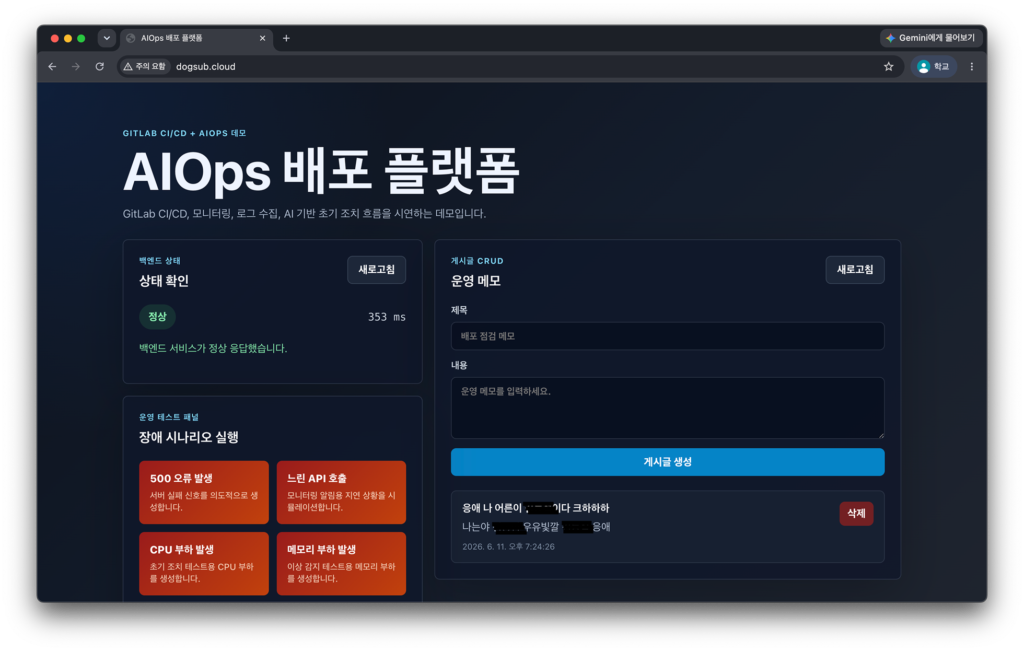
마지막에는 서비스 상태를 한눈에 볼 수 있는 모니터링 화면을 만들었습니다. 문제가 생기면 AI가 기록과 상태 정보를 확인해 사람이 이해하기 쉽게 요약해주는 흐름을 설계했습니다.
가비아 클라우드에서 사용한 서비스
AIOps 스터디에서 경험한 가비아 클라우드 서비스는 아래와 같습니다.
| 가비아 클라우드에서 사용한 것 | 프로젝트에서 어떤 역할을 했는지 |
|---|---|
| 가상 서버 | 웹사이트, 기능 처리 서버, 데이터베이스, 모니터링, AI 도우미를 실행하는 공간 |
| 로드밸런서 | 사용자의 요청을 적절한 서버로 보내주는 입구 |
| 보안그룹 | 외부에 공개할 부분과 내부에서만 접근할 부분을 나누는 문지기 역할 |
| 컨테이너 레지스트리 | 배포할 프로그램 이미지를 저장하고 서버에서 가져가는 저장소 |
| 주소 연결/도메인 | 사용자가 숫자로 된 서버 주소가 아니라 dogsub.cloud라는 이름으로 접속할 수 있게 해주는 기능 |
| 통신 경로표 | 외부와 내부 서버 영역을 더 명확하게 나누는 기능 |
실제 서비스 흐름
최종적으로 만든 사용자 흐름은 아래와 같습니다.
사용자 요청 처리 흐름
장애 감지 및 알림 흐름
dogsub.cloud 서비스 흐름 (모든 구성 요소는 가비아 클라우드 위에서 동작)
이 흐름을 직접 구현해보면서 클라우드가 단순히 “서버를 빌려 쓰는 곳”이 아니라 서비스를 안정적으로 운영하기 위한 여러 도구를 제공하는 환경이라는 것을 체감할 수 있었습니다.
모니터링과 AI 알림
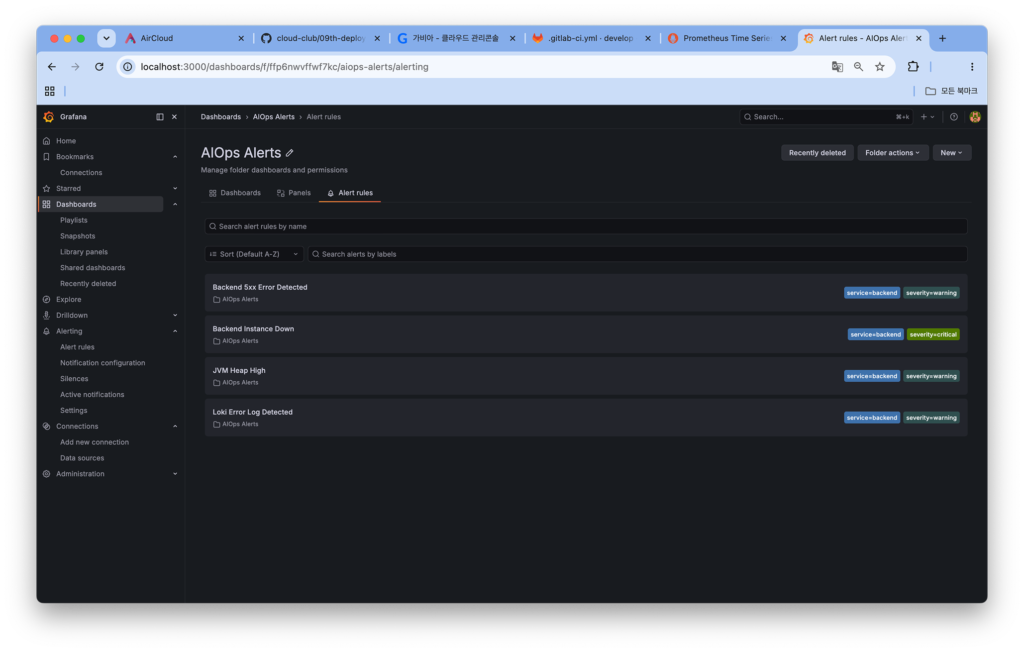
서비스를 만들 때 중요한 것은 ‘잘 동작하는지’를 계속 확인하는 일입니다. 이번 스터디에서는 서버 상태를 한눈에 볼 수 있는 대시보드를 구성했습니다. 어떤 서버가 살아있는지, 요청이 얼마나 들어오는지, 오류가 발생하는지 확인할 수 있었습니다.
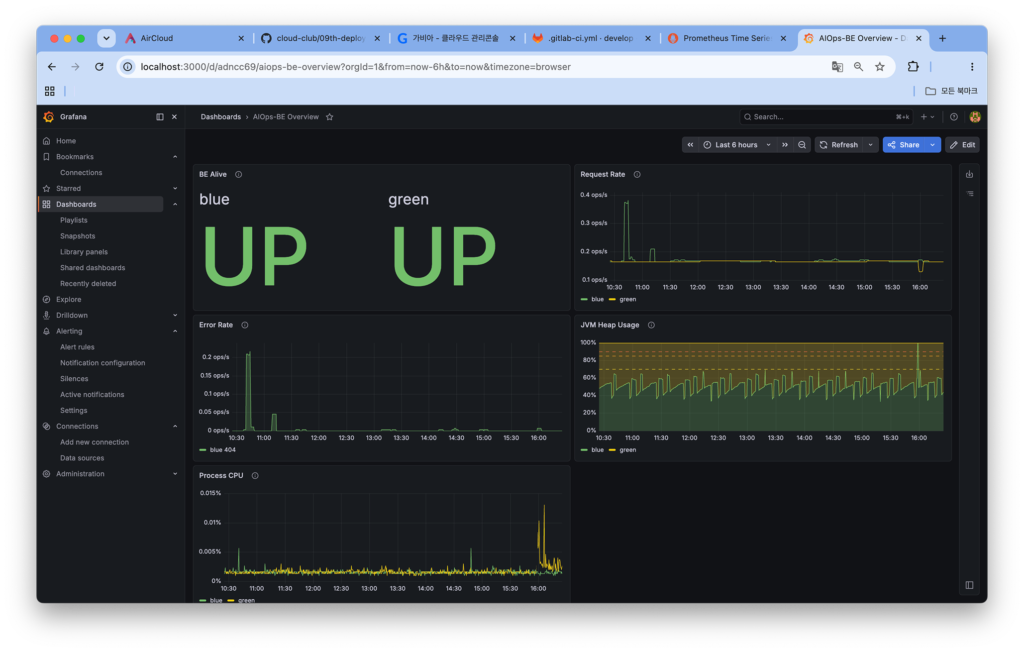
문제가 생겼을 때는 알림이 오도록 설정했습니다. 단순히 “문제가 생겼습니다”에서 끝나는 것이 아니라, AI가 문제 상황을 읽고 사람이 이해하기 쉬운 말로 설명해주는 구조를 만들었습니다.
스터디원 후기
“도메인, 로드밸런서, 컨테이너 이미지 저장소, 모니터링 서버까지 한 번에 연결해보니 클라우드가 훨씬 현실적으로 느껴졌습니다.”
“혼자였다면 비용 때문에 서버 여러 대를 마음껏 만들어보기 어려웠을 텐데 가비아 클라우드 지원 덕분에 실제 서비스와 비슷한 구조를 실습할 수 있었습니다.”
마치며
가비아 클라우드와 함께한 Cloud Club 9기 스터디 후기 어떻게 보셨나요? 커널 레벨 네트워크 분석부터 장애 대응, AIOps 배포까지 주제는 달랐지만 세 스터디 모두 환경 구축 부담을 덜고 본래의 학습 목표에 집중했다는 공통점이 있습니다.
가비아 클라우드는 앞으로도 Cloud Club의 활동을 지원하며 클라우드 네이티브 기술이 실제로 구현되는 국내 인프라 서비스로 나아갈 예정입니다.
다음 Cloud Club 기수에도 가비아 클라우드의 지원이 이어질 예정입니다. 클라우드와 배포를 제대로 경험해보고 싶은 분들이라면 Cloud Club의 소식에 관심을 가져보세요!